چرا سانسور در مدلهای هوش مصنوعی چینی نگرانکننده است؟
وقتی این گزارش را خواندم، اولین سؤالی که برای خودم مطرح شد این بود که: «اگر مدلهای هوش مصنوعی چینی سانسور دارند، آیا این سانسور مستقیم به کاربر عادی میرسد و ذهنش را تحت تأثیر قرار میدهد؟» در بررسی دقیقتر، دیدم پژوهش تازهای نشان میدهد سانسوری که داخل خودِ مدل چینی هست، لزوماً به مدلی که از روی آن ساخته میشود منتقل نمیشود.
در ادامه سعی میکنم خیلی ساده توضیح بدهم که این یعنی چه، چه ربطی به کاربر عادی دارد و اگر از هوش مصنوعی (روی موبایل یا وب) استفاده میکنید، دقیقاً باید حواستان به چه چیزهایی باشد.
داستان از کجا شروع شد؟ سانسور در مدلهای هوش مصنوعی چینی یعنی چه؟
در بررسی این ماجرا اول باید بفهمیم «سانسور در مدل هوش مصنوعی» یعنی چه. وقتی یک مدل چت هوش مصنوعی را باز میکنید و از آن درباره موضوعات حساس (مثلاً سیاست، اقلیتها، وقایع تاریخی) میپرسید، بعضی مدلها:
- یا اصلاً جواب نمیدهند (میگویند مجاز به پاسخ نیستم)،
- یا جواب را طوری عوض میکنند که با خط مشی سیاسی یا قانونی آن کشور هماهنگ باشد.
در مدلهای چینی، طبق قوانین داخلی آن کشور، موضوعاتی مثل اردوگاههای بازداشت اویغورها، میدان تیانآنمن و نقد مستقیم دولت چین جزء حوزههای بسیار حساس هستند. در بررسی نمونههایی که در گزارش آمده بود، دیدم:
- مدل اصلی چینی، وجود اردوگاههای بازداشت را انکار میکرد یا طوری جواب میداد که همهچیز عادی و مثبت به نظر برسد.
- اما مدلی که بعداً از روی همین مدل ساخته شده بود، همان سؤال را واقعیتر جواب میداد و وجود بازداشتگاهها را تأیید میکرد.
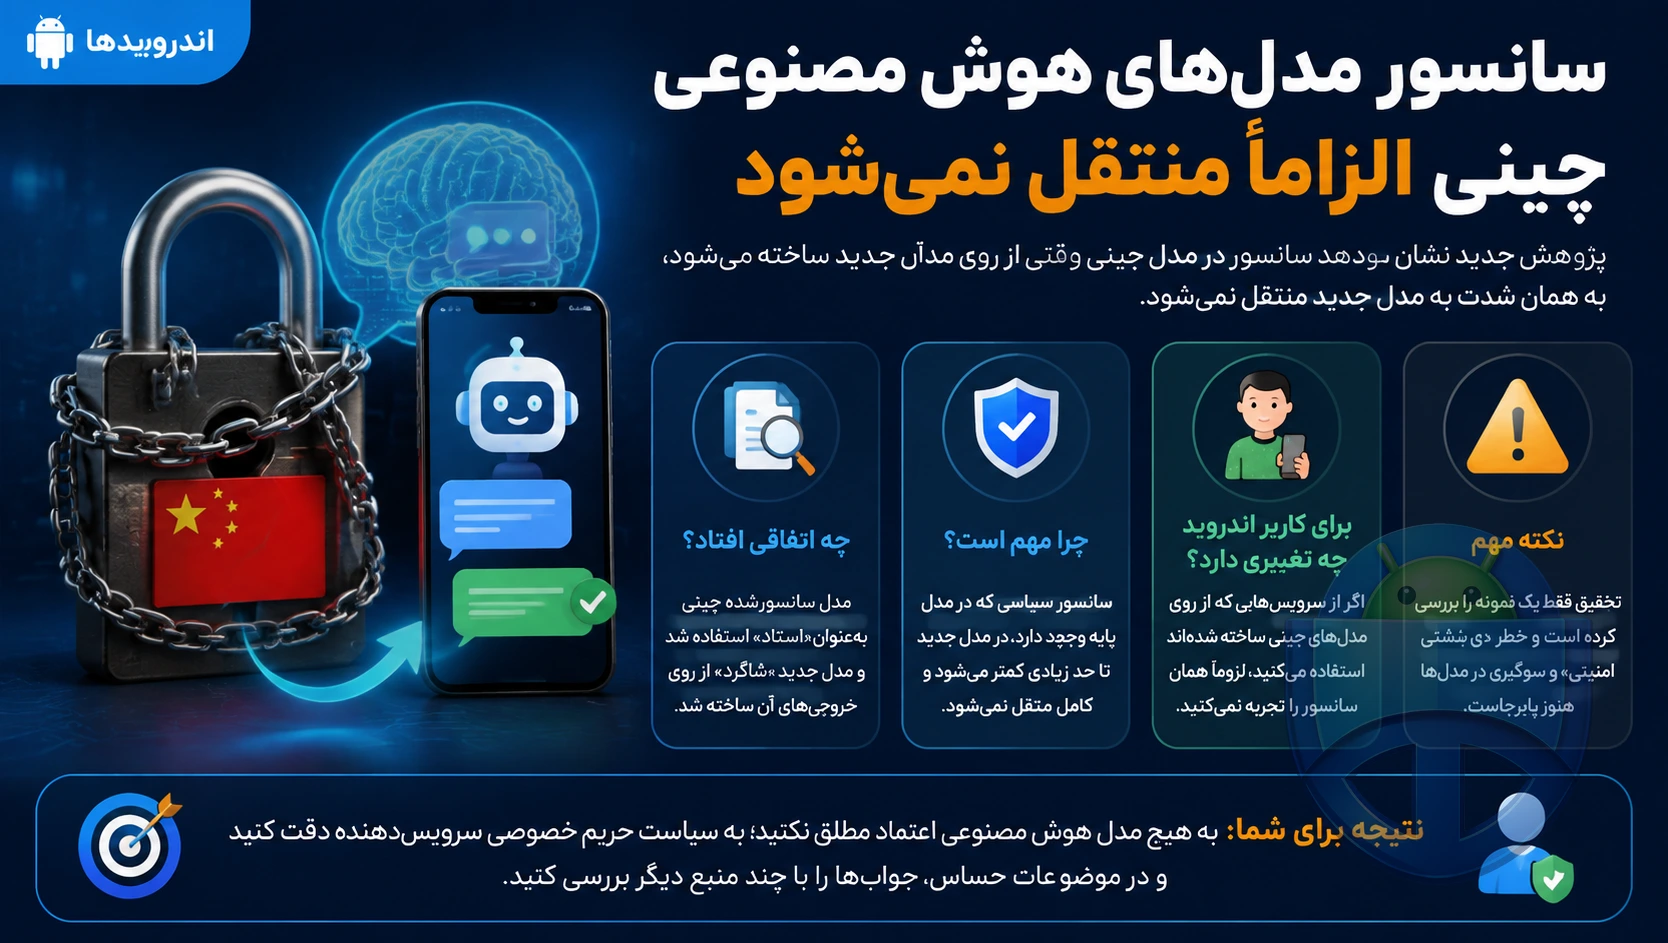
نکته مهم اینجا بود: ظاهراً سانسور داخل مدل اصلی، به همان شدت به مدل جدید منتقل نشده بود.
مدل «استاد» و «شاگرد» چیست و چرا مهم است؟
در این تحقیق برای بررسی سانسور از روشی استفاده شده که در دنیای هوش مصنوعی خیلی رایج است و به آن «تقلیل» یا distillation میگویند. من وقتی روند را دنبال کردم، متوجه شدم بهتر است آن را مثل رابطه معلم و شاگرد ببینیم:
- مدل استاد (Teacher): یک مدل بزرگ و قوی که جواب خیلی از سؤالها را میداند، اما ممکن است سانسور شده باشد یا قوانین سختگیرانهای روی آن اعمال شده باشد.
- مدل شاگرد (Student): یک مدل کوچکتر و سبکتر که «از روی خروجیهای مدل استاد» آموزش میبیند؛ یعنی استاد جواب میدهد، شاگرد از روی آن جوابها یاد میگیرد.
در این تحقیق، تیم پژوهشی:
- از یک مدل چینی به عنوان «استاد» استفاده کرد.
- به آن سؤالهای مختلف، از جمله سؤالهای حساس سیاسی، پرسید و خروجیها را ذخیره کرد.
- با همین خروجیها، یک مدل جدید «شاگرد» ساخت.
- بعد هر دو را با یکسری سؤال حساس و غیر حساس آزمود و نتایج را مقایسه کرد.
چیزی که در بررسی نتایج برای من جالب بود این بود که:
- مدل استاد (چینی) طبق انتظار، روی موضوعات مربوط به چین یا جواب نمیداد یا سفیدنمایی میکرد.
- اما مدل شاگرد، در بسیاری موارد، جوابهای کمتر سانسور شده و نزدیکتر به واقعیت ارائه میداد.
یعنی سانسور، به همان شدت از «استاد» به «شاگرد» منتقل نشده بود.
این موضوع چه ربطی به کاربر عادی دارد؟
اگر شما به عنوان یک کاربر عادی از اپها و سرویسهای مختلف هوش مصنوعی استفاده میکنید (مثلاً چتباتهای ترجمه، کمک در نوشتن متن، تحلیل داده، یا حتی رباتهای داخل برنامهها)، چند نکته مهم اینجا برایتان وجود دارد:
- خیلی از سرویسها، بهخصوص سرویسهای ارزانتر، از «مدلهای متنباز چینی» به عنوان پایه استفاده میکنند یا از روی آنها مدل جدید میسازند.
- ترس اصلی این بود که «اگر مدل پایه چینی سانسور دارد، مدل جدید هم همان سانسور را بهطور پنهان به کاربر منتقل میکند».
- اما طبق این تحقیق، حداقل در این نمونه، سانسور کاملاً به مدل جدید منتقل نشده و تا حد زیادی «خفه» شده است.
در عمل، یعنی اگر شما با یک مدل که ظاهراً از روی مدل چینی ساخته شده کار کنید، لزوماً قرار نیست همان سانسور را تجربه کنید. البته این تضمین ۱۰۰٪ نیست، ولی این تحقیق نشان میدهد:
- ترس از اینکه «هر مدل مبتنی بر چین لزوماً مغزش با پروپاگاندا پر شده» اغراقآمیز است.
- با این حال، هنوز هم باید حواستان باشد که مدلها در حوزه سیاست و خبر، همیشه ۱۰۰٪ بیطرف نیستند؛ چه چینی باشند، چه آمریکایی، چه هر جای دیگر.
آیا این یعنی مدلهای چینی کاملاً بیخطر شدهاند؟
در بررسی این گزارش، دو نگرانی اصلی دیده میشد که سیاستمداران و شرکتها درباره مدلهای چینی دارند:
- ۱. سانسور و جهتدهی سیاسی: اینکه مدلها دیدگاه خاصی را در مورد تاریخ، سیاست و رویدادها جا بیندازند.
- ۲. درِ پشتی (Backdoor) و امنیت: اینکه داخل مدل یا سیستم، کدی پنهان باشد که اطلاعات شما را جاسوسی کند یا در شرایطی خاص، رفتار خطرناک انجام دهد.
این تحقیق فقط نگرانی اول را تا حدی بررسی کرده و نشان داده سانسور در مدل استاد الزاماً به مدل شاگرد منتقل نمیشود. اما درباره نگرانی دوم (در پشتی امنیتی) هنوز هیچ شواهد قطعی وجود ندارد. در متنهای تحلیلی که خواندم، تأکید شده بود:
- تا امروز هیچ مدرک محکم عمومی که نشان دهد مدلهای چینی عمداً اطلاعات را میدزدند منتشر نشده است.
- ترس وجود دارد، اما بیشتر در حد نگرانی تئوریک است تا سند قطعی.
از دید کاربر عادی، نتیجه عملی این است:
- در استفاده از سرویسهای هوش مصنوعی، صرفاً به «کشور سازنده» نگاه نکنید.
- بیشتر به اعتبار سرویسدهنده، سیاست حریم خصوصی و شفافیت در نحوه استفاده از دادهها دقت کنید.
این تحقیق دقیقاً چه کاری انجام داد و محدودیتهایش چیست؟
وقتی جزئیات روش تحقیق را نگاه کردم، چند نکته مهم دیدم که برای قضاوت نتیجه باید در نظر بگیریم:
- فقط روی یک جفت مدل (یک استاد چینی و یک شاگرد) انجام شده است، پس نمیتوان گفت همه مدلهای چینی دقیقاً همین رفتار را دارند.
- تمرکز روی سانسور سیاسی درباره چین بوده، نه همه نوع سانسور یا همه نوع موضوع.
- برای ارزیابی جوابها از چند مدل بزرگ دیگر کمک گرفته شده تا تشخیص بدهند پاسخها سانسور شدهاند یا نه؛ این خودش میتواند خطا داشته باشد، ولی فعلاً یکی از عملیترین روشهاست.
- این تحقیق هنوز توضیح نمیدهد چرا سانسور کامل منتقل نشده؛ فقط نشان میدهد که در عمل، شدت سانسور در مدل شاگرد کمتر است.
بنابراین، برای من نتیجهگیری منطقی این است:
- این یک نشانه مثبت است، اما کافی نیست که بگوییم «مشکل سانسور مدلهای چینی حل شد».
- به تحقیقات بیشتر روی مدلهای مختلف و سناریوهای گستردهتر نیاز است.
چرا شرکتها هنوز درباره استفاده از مدلهای چینی مردد هستند؟
در تجربه پیگیری اخبار کسبوکارها، دیدم بسیاری از شرکتها، مخصوصاً در حوزههای حساس مثل مالی و بانکی، چند دلنگرانی اصلی دارند:
- نگرانی از سانسور پنهان در تحلیلها: مثلاً اگر مدل قرار است ریسک بازار مسکن چین را تحلیل کند، آیا به خاطر سانسور، خطر واقعی را کوچکنمایی میکند؟
- ترس از واکنش افکار عمومی و دولتها: اگر مشخص شود یک شرکت بزرگ مالی در آمریکا یا اروپا از مدل پایه چینی استفاده میکند، ممکن است با هجمه رسانهای یا فشار سیاسی روبهرو شود.
- ابهام در قوانین: هنوز خیلی از کشورها دستورالعملهای واضحی برای استفاده از مدلهای خارجی (کلاً، نه فقط چینی) ندارند؛ شرکتها ترجیح میدهند صبر کنند تا مقررات مشخصتر شود.
با وجود این، چون مدلهای چینی معمولاً:
- ارزانتر هستند،
- و دسترسی به آنها آسانتر است،
بسیاری از کسبوکارها وسوسه میشوند از آنها استفاده کنند یا حداقل از رویشان مدل جدید بسازند. این تحقیق میتواند برای این شرکتها یک استدلال باشد که:
- «اگر درست از روش مدل شاگرد استفاده کنیم، میتوانیم سانسور را تا حد زیادی پشت سر بگذاریم.»
لبه تیز ماجرا: حذف سانسور یعنی حذف بقیه محدودیتها هم ساده است
یک نکته، در بررسی این ماجرا، برای خود من کمی نگرانکننده بود. اگر بشود سانسور چینی را به این راحتی کمرنگ کرد، یعنی:
- به همان راحتی میشود بقیه محدودیتها و گاردریلهای ایمنی را هم دور زد.
مثلاً اگر یک مدل بهطور پیشفرض اجازه نمیدهد:
- آموزش ساخت بدافزار بدهد،
- یا راهنمای حملات سایبری و هک ارائه کند،
ممکن است کسی با روشهای مشابه (استاد–شاگرد یا تنظیم دوباره مدل) این محدودیتها را بردارد و یک نسخه «آزادتر» و خطرناکتر بسازد. یعنی همان ابزاری که سانسور را کم میکند، میتواند برای برداشتن حفاظهای امنیتی هم استفاده شود.
از دید کاربر، نتیجهای که من میگیرم این است:
- باید انتظار داشته باشیم در سالهای آینده مدلهایی در دسترس باشند که تقریباً هیچ محدودیتی ندارند، چه برای سانسور سیاسی، چه برای استفادههای خطرناک.
- پس نقش قوانین، آموزش کاربران و مسئولیت سرویسدهندهها از خودِ سانسور داخلی مدلها مهمتر میشود.
اگر کاربر عادی هستم، در عمل چه کار کنم؟
اگر شما فقط میخواهید از هوش مصنوعی برای کارهای روزمره (ترجمه، خلاصهسازی متن، ایدهپردازی، کمک در مطالعه) استفاده کنید، چند نکته عملی از این ماجرا برایتان مهم است:
- ۱. به مدل اعتماد مطلق نکنید: چه مدل چینی باشد چه غیر چینی، جوابهای مرتبط با سیاست، تاریخ، اخبار و مسائل حساس را همیشه با چند منبع دیگر چک کنید.
- ۲. سیاست حریم خصوصی سرویس را بخوانید: ببینید سرویسدهنده گفته دادههای شما را کجا ذخیره و چگونه استفاده میکند؛ این مهمتر از محل تولد مدل است.
- ۳. برای موضوعات حساس، از مدلهای معتبرتر استفاده کنید: اگر قرار است بر اساس خروجی مدل تصمیم مالی، حقوقی یا سیاسی بگیرید، سراغ سرویسهایی بروید که شفافتر، شناختهشدهتر و تحت نظارت بیشتری هستند.
- ۴. حواستان به نشت اطلاعات باشد: حتی بدون «در پشتی»، هر متنی که به یک سرویس آنلاین میدهید ممکن است جایی ذخیره شود؛ اطلاعات خیلی شخصی، رمزها و دادههای محرمانه کاری را در هیچ چتباتی ننویسید.
سؤالات متداول
آیا همه مدلهای چینی دقیقاً همین رفتار را دارند؟
نه. تحقیقی که در اینجا به آن اشاره شد، فقط یک مدل چینی و یک مدل شاگرد را بررسی کرده است. نتیجهاش نشانهای مثبت است، اما نمیتوان آن را به همه مدلهای چینی تعمیم داد.
آیا قطعاً هیچ «در پشتی» در مدلهای چینی وجود ندارد؟
هیچ مدرک عمومی و قطعی که نشان دهد مدلهای چینی عمداً برای جاسوسی طراحی شدهاند منتشر نشده است، اما نبود مدرک به معنی نبود خطر نیست. در هر صورت بهتر است همیشه در استفاده از سرویسهای آنلاین، چه چینی چه غیر چینی، اصول امنیت و حریم خصوصی را رعایت کنید.
آیا استفاده از مدلهایی که از روی مدلهای چینی ساخته شدهاند امن است؟
این تحقیق نشان داده سانسور سیاسی الزاماً کامل منتقل نمیشود، اما امنیت به عوامل دیگری مثل زیرساخت، نحوه ذخیرهسازی داده و سیاستهای شرکت سرویسدهنده هم بستگی دارد. امنیت را باید در سطح سرویس نهایی ارزیابی کنید، نه فقط منبع مدل.
آیا این نتایج یعنی دیگر نیازی به قانونگذاری برای هوش مصنوعی نیست؟
خیر. حتی اگر سانسور چینی راحتتر حذف شود، همین قابلیت میتواند برای حذف سایر حفاظهای امنیتی هم به کار برود. اتفاقاً نیاز به قانونگذاری و نظارت، هم در کشورهای سازنده و هم در کشورهای مصرفکننده بیشتر احساس میشود.
برای کارهای روزمره مثل ترجمه و نوشتن متن، لازم است نگران سانسور سیاسی باشم؟
در بیشتر استفادههای روزمره، تأثیر سانسور سیاسی کم است. اما اگر روی موضوعات حساس تاریخی، سیاسی یا خبری کار میکنید، بهتر است خروجی مدل را با چند منبع دیگر مقایسه کنید و آن را تنها منبع حقیقت ندانید.
جمعبندی تجربه من از این قابلیت
در جمعبندی بررسی این گزارش، برای من روشن شد که ماجرا نسبت به آن چیزی که معمولاً در بحثها مطرح میشود پیچیدهتر است. از یک طرف، اینطور به نظر میرسد که سانسور سیاسی در مدلهای چینی به همان شدت به مدلهای مشتقشده منتقل نمیشود و این میتواند خبر خوبی برای شرکتها و کاربران باشد. از طرف دیگر، همین قابلیت دورزدن سانسور نشان میدهد در آینده، ساخت مدلهایی بدون تقریباً هیچ محدودیتی (چه خوب، چه خطرناک) هم سادهتر میشود.
برای یک کاربر عادی، مهمترین نکته این است که به هیچ مدل هوش مصنوعی، صرفنظر از کشور سازنده، اعتماد مطلق نکند؛ خصوصاً در موضوعات حساس. بهجای تمرکز صرف روی برچسب «چینی» یا «غیرچینی»، بهتر است به شفافیت سرویسدهنده، سیاست حریم خصوصی و نحوه برخورد آن با دادههای شما دقت کنید. محدودیت اصلی فعلاً دانایی و دقت ما در استفاده از این ابزارهاست، نه فقط سانسور داخل خود مدلها.
من زینب سردار، کارشناس تیم تحریریه اندرویدها هستم. اگر درباره این موضوع سؤال یا تجربهای دارید، در بخش نظرات با من مطرح کنید.
گوگل یه قابلیت جدید آورده که ۹۰٪ هنوز خبر ندارن! 🤫
روی دکمه بزن و توی صفحهای که باز میشه فقط تیک کنار «اندروید ها» رو بزن. تمام ✅ از این به بعد گوگل آپدیت واتساپ، تلگرام و بازیهای جدید رو اول از همه به خودت نشون میده.
⭐ همین الان فعالش کنتوضیحات نوشتار
- نویسنده: زینب سردار
- تاریخ انتشار: 1405/05/19
- تاریخ بهروزرسانی: 1405/05/19
